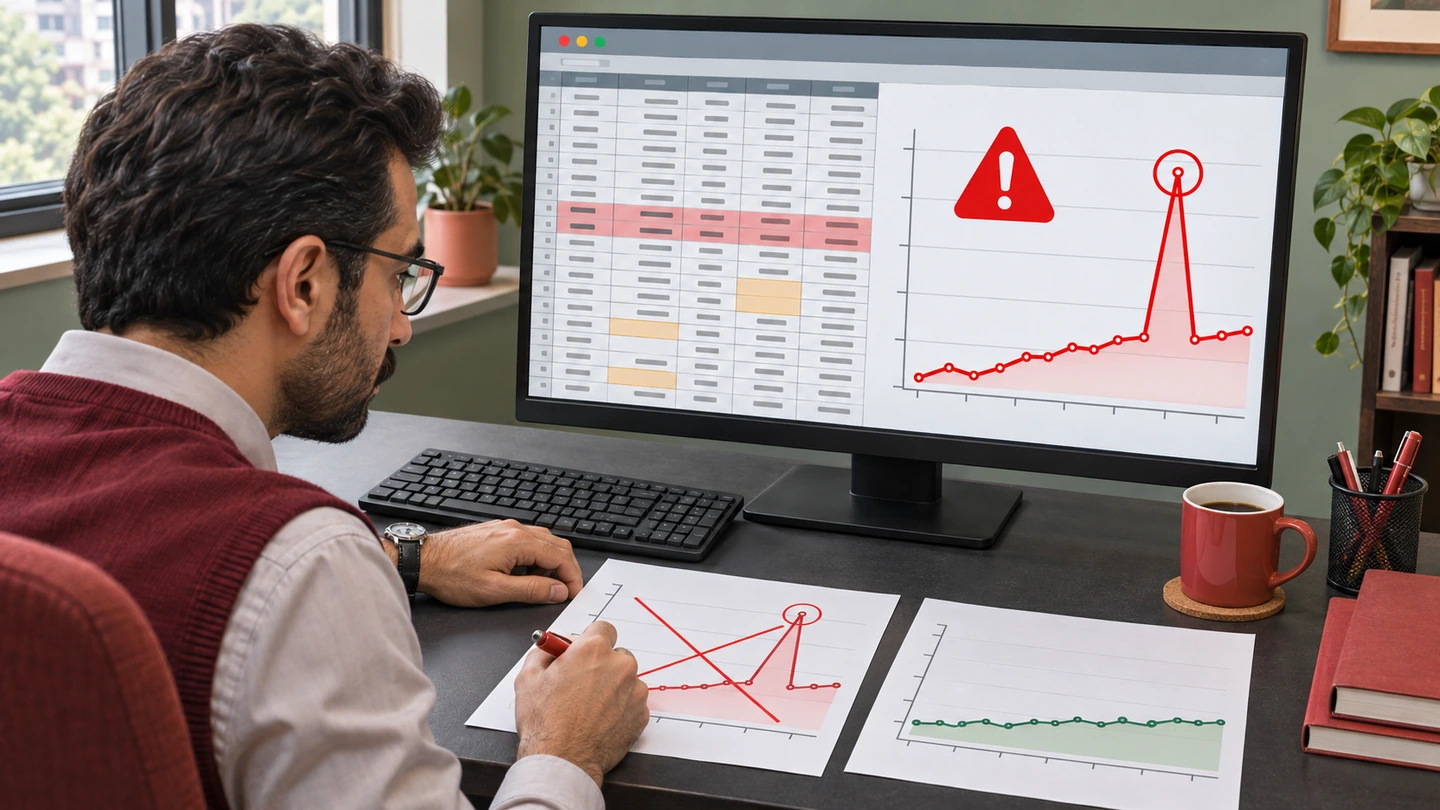
گزارش فروش رشد کرده، اما سفارشهای واقعی کمتر شدهاند. ممکن است محاسبه درست باشد، ولی تعریف «فروش» عوض شده باشد، سفارشهای لغوشده هم شمرده شده باشند یا یک سفارش چند بار وارد گزارش شده باشد. اشتباهات رایج در تحلیل داده همیشه خطاهای پیچیدهٔ آماری نیستند؛ گاهی یک ستون خالی یا مقایسهٔ دو بازهٔ متفاوت، نتیجه را تغییر میدهد.
برای ارزیابی یک تحلیل، باید بتوانید از نتیجه به دادهٔ اولیه برگردید: هر عدد از کجا آمده، چه چیزی را اندازه میگیرد و چه محدودیتی دارد؟ در این راهنما، ۱۰ خطای مهم را با مثالهای کسبوکاری بررسی میکنیم و برای هرکدام یک راه کنترل پیشنهاد میدهیم.
۱۰ اشتباه رایج در تحلیل داده و راه جلوگیری از آنها
۱. شروع تحلیل بدون سؤال مشخص
«دادههای مشتریان را تحلیل کنیم» هدف روشنی نیست. مشخص کنید قرار است کدام تصمیم تغییر کند. برای نمونه، «آیا تأخیر در ارسال با کاهش خرید دوباره همراه است؟» از «چرا فروش کم شده؟» قابلبررسیتر است؛ به شرط آنکه تعریف تأخیر و بازهٔ خرید دوباره هم معلوم باشد.
پیش از ساخت گزارش، سؤال، گروه مورد بررسی، بازهٔ زمانی و شاخص اصلی را بنویسید. اگر هدف سنجش بازگشت مشتری است، تعداد بازدید سایت بهتنهایی پاسخ سؤال را نمیدهد. برای آشنایی با مسیر کلی این کار، مقالهٔ تحلیل داده چیست؟ نقطهٔ شروع مناسبی است.
۲. شمارش تکراری یا ترکیب دادههایی با معنای متفاوت
هر ردیف فایل چه چیزی را نشان میدهد: یک مشتری، یک سفارش یا یک قلم از سفارش؟ اگر یک سفارش سه کالا داشته باشد، ممکن است در فایل جزئیات سه ردیف برای آن وجود داشته باشد. جمعزدن مبلغ کل سفارش در هر سه ردیف، فروش را سه برابر حساب میکند.
قبل و بعد از اتصال فایلها، تعداد شناسههای یکتا و جمع مبلغ را مقایسه کنید. همچنین واحدها، وضعیت سفارش و مبنای تاریخ را یکسان کنید؛ مبلغ ریال را با تومان جمع نزنید و تاریخ پرداخت را بدون توضیح با تاریخ ثبت سفارش مخلوط نکنید. ردیفهای شبیه هم را هم صرفاً به دلیل شباهت حذف نکنید؛ ممکن است دو خرید مستقل باشند.
۳. برابر گرفتن دادهٔ خالی با صفر
«فروش این شعبه صفر است» با «فروش این شعبه هنوز ثبت نشده» فرق دارد. اگر دادهٔ ثبتنشده را صفر بگذارید، میانگین فروش پایین میآید و شاید یک شعبهٔ فعال، ضعیف به نظر برسد. حذف بیبررسی ردیفهای ناقص هم میتواند بخش مشخصی از مشتریان یا سفارشها را از تحلیل کنار بگذارد.
تعداد و محل دادههای خالی را گزارش کنید و علت را بپرسید: ثبت با تأخیر انجام میشود، سؤال برای آن فرد کاربرد ندارد یا اتصال سیستم قطع شده است؟ تصمیم به حذف یا جایگزینی باید متناسب با همین علت باشد. نسخهٔ خام را نگه دارید و اثر انتخابتان بر نتیجه را بررسی کنید؛ پرکردن همهٔ خانههای خالی با میانگین، راهحل عمومی نیست.
۴. تعمیم نتیجهٔ یک گروه محدود به همه
اگر نظرسنجی فقط برای مشتریان فعال ارسال شده باشد، پاسخها تجربهٔ افرادی را که خرید را نیمهکاره رها کردهاند نشان نمیدهد. همین مسئله در تحلیل شکایتها هم وجود دارد: نبود شکایت الزاماً به معنی رضایت نیست، چون همهٔ افراد ناراضی شکایت ثبت نمیکنند.
گروه هدف را تعریف کنید و ببینید چه کسانی امکان حضور در داده را نداشتهاند یا پاسخ ندادهاند. تعداد زیاد پاسخ، بهتنهایی این سوگیری را رفع نمیکند. اگر داده فقط مربوط به یک کانال فروش یا مشتریان یک شهر است، نتیجه را هم در همان محدوده بیان کنید؛ برای تعمیم به گروههای دیگر شواهد جداگانه لازم است.
۵. مقایسهٔ عددها بدون مخرج و شرایط یکسان
۱۰۰ سفارش از ۱۰۰۰ بازدید با ۱۰۰ سفارش از ۵۰۰۰ بازدید، تعداد خرید یکسانی دارد، اما نرخ تبدیل یکسانی ندارد. از طرف دیگر، نرخ تبدیل را باید با تعریف ثابتی محاسبه کرد؛ یک بار بر پایهٔ کاربر و بار دیگر بر پایهٔ نشست، مقایسه را خراب میکند.
در مقایسهٔ زمانی هم تعداد روزهای کاری، مناسبتها، تغییر قیمت، موجودی و ترکیب محصولات را در نظر بگیرید. رشد مبلغ فروش ممکن است بخشی از افزایش قیمت باشد، نه افزایش تعداد فروش. ماه نیمهتمام را با ماه کامل نسنجید و کنار هر درصد، تعداد اولیه و تعریف شاخص را نشان دهید.
۶. تکیه بر میانگین و پنهان کردن تفاوتها
فرض کنید زمان پاسخگویی به پنج درخواست، ۱، ۲، ۲، ۳ و ۲۲ ساعت باشد. میانگین ۶ ساعت است، اما میانه ۲ ساعت است. هیچکدام بهتنهایی تجربهٔ همهٔ مشتریان را توضیح نمیدهد: چهار درخواست زود پاسخ گرفتهاند و یک درخواست بسیار دیر.
بسته به سؤال، میانگین را کنار میانه، تعداد موارد و پراکندگی بررسی کنید. تفکیک بر اساس نوع درخواست یا شعبه هم ممکن است تفاوت مهمی را آشکار کند. برای سنجش ظرفیت تیم، میانگین میتواند مفید باشد؛ برای فهم تجربهٔ معمول مشتری و موارد دیرهنگام، اطلاعات بیشتری نیاز دارید. شاخص را بر اساس تصمیم انتخاب کنید.
۷. حذف خودکار دادههای پرت
یک سفارش بسیار بزرگ شاید خطای ورود داده باشد، اما شاید خرید واقعی یک مشتری عمده باشد. حذف آن فقط برای مرتبتر شدن نمودار، تصویر کسبوکار را عوض میکند. در مقابل، پذیرفتن مبلغی با یک صفر اضافی هم نتیجه را منحرف میکند.
ابتدا منبع رکورد، واحد، زمان و شرایط وقوع را بررسی کنید. خطای تأییدشده را اصلاح کنید؛ یک رخداد واقعی را صرفاً به دلیل غیرعادی بودن حذف نکنید. اگر آن رکورد بر نتیجه اثر زیادی دارد، خروجی را با حضور و بدون حضور آن مقایسه و علت تفاوت را توضیح دهید. راهنمای NIST هم بر بررسی دادهٔ پرت پیش از تصمیم به کنارگذاشتن آن تأکید دارد.
۸. اشتباه گرفتن همبستگی با علت
ممکن است همزمان با شروع تبلیغات، فروش افزایش پیدا کند. این همزمانی بهتنهایی ثابت نمیکند که تمام رشد نتیجهٔ تبلیغات بوده است؛ تخفیف، فصل خرید یا رفع کمبود موجودی هم ممکن است تغییر کرده باشد.
در گزارش، «همراه بودن دو تغییر» را از «اثبات اثر یک اقدام» جدا کنید. برای بررسی اثر، طراحی مقایسه اهمیت دارد؛ مثلاً یک آزمایش کنترلشدهٔ مناسب، در صورت امکان، شواهد قویتری از مقایسهٔ سادهٔ قبل و بعد میدهد. نمودار پراکندگی رابطه را نشان میدهد، اما بهتنهایی علت را ثابت نمیکند.
۹. انتخاب نموداری که اختلاف را بزرگنمایی میکند
وقتی محور یک نمودار ستونی از عددی نزدیک به مقدار ستونها شروع شود، یک اختلاف کوچک ممکن است چند برابر به نظر برسد. نمایش سهبعدی، حذف بخشی از بازه یا انتخاب رنگهای مبهم هم میتواند برداشت مخاطب را تغییر دهد.
برای نمودار ستونی، مبنای صفر را حفظ کنید، چون طول ستونها قرار است مقدار را نشان دهد. این قاعده را بیتفاوت به نوع نمودار تعمیم ندهید؛ در نمودار خطی، شروع محور از غیرصفر میتواند مناسب باشد، به شرط آنکه مقیاس و بازه واضح باشند. واحد، منبع، تاریخ و دادههای حذفشده را مشخص کنید و از نمودار فقط برای پاسخ به یک سؤال روشن استفاده کنید.
۱۰. انتخاب گزینشی نتیجه و ثبت نکردن مسیر تحلیل
اگر دهها گروه و بازه را بررسی کنید و فقط همان موردی را نشان دهید که رشد چشمگیر دارد، گزارش کامل نیست. ممکن است آن الگو تصادفی، محدود به یک گروه کوچک یا وابسته به انتخاب بازه باشد. خروجی یک ابزار هوش مصنوعی هم بدون بررسی تعریف شاخص و محاسبهها، اعتبار بیشتری پیدا نمیکند.
شاخص اصلی را پیش از بررسی نتیجه مشخص کنید، یافتههای تازه را بهعنوان موضوع بررسی بیشتر جدا کنید و محدودیتها را بنویسید. منبع فایل، زمان استخراج، فیلترها، فرمولها و تغییرات پاکسازی را ثبت کنید تا فرد دیگری بتواند نتیجه را بازسازی کند. برای یافتههای ناشی از نمونهگیری، اندازهٔ نمونه و عدم قطعیت را هم متناسب با روش گزارش دهید؛ نمایش چند رقم اعشار، جای این اطلاعات را نمیگیرد.
یک مثال: چرا فروش بیشتر همیشه نشانهٔ عملکرد بهتر نیست؟
یک فروشگاه میخواهد نتیجهٔ تغییر صفحهٔ محصول را بررسی کند. فرض کنید دادههای دو بازهٔ همطول چنین باشند:
| شاخص | بازهٔ اول | بازهٔ دوم |
|---|---|---|
| نشستهای بازدید صفحهٔ محصول | ۱۰۰۰ | ۲۰۰۰ |
| نشستهای منجر به خرید | ۵۰ | ۶۰ |
| نرخ تبدیل نشست به خرید | ۵٪ | ۳٪ |
تعداد نشستهای منجر به خرید ۲۰٪ بیشتر شده است، اما نرخ تبدیل از ۵٪ به ۳٪ رسیده؛ یعنی ۲ واحد درصد کاهش داشته است. «۲ واحد درصد» با «۲ درصد کاهش» یکسان نیست: کاهش نسبی نرخ تبدیل در این مثال ۴۰٪ است.
از این اعداد نمیتوان نتیجه گرفت تغییر صفحه علت افت نرخ تبدیل بوده است. شاید تبلیغ جدید، بازدیدکنندگانی با قصد خرید کمتر آورده یا موجودی یک محصول پرفروش تمام شده باشد. ابتدا یکسان بودن ثبت رویدادها، ترکیب ترافیک و شرایط دو بازه را بررسی کنید. این مثال نشان میدهد یک عدد درست هم ممکن است به یک نتیجهگیری نادرست منجر شود.
چکلیست بررسی گزارش قبل از تصمیمگیری
- سؤال: گزارش قرار است به کدام تصمیم مشخص کمک کند؟
- معنای هر ردیف: مشتری، سفارش، قلم کالا یا رویداد را میشماریم؟
- کیفیت داده: رکورد تکراری، مقدار خالی، اختلاف واحد و تأخیر ثبت بررسی شدهاند؟
- دامنه: چه گروهها یا بازههایی در داده حضور ندارند؟
- مقایسه: مخرج شاخص، بازه و شرایط دو گروه یکسان است؟
- تفسیر: نتیجه فقط یک رابطه را نشان میدهد یا برای ادعای علت شواهد کافی داریم؟
- بازبینی: آیا میتوان چند رکورد را تا منبع اصلی دنبال کرد و محاسبه را دوباره انجام داد؟
برای گزارشهای تکرارشونده، این کنترلها را در فرایند آمادهسازی داده قرار دهید تا هر بار وابسته به حافظهٔ یک نفر نباشند. در راهنمای تبدیل دادههای اکسل به داشبورد مدیریتی، تعریف شاخص و آمادهسازی منبع را پیش از طراحی نمودار بررسی کردهایم.
چه زمانی اصلاح فایل کافی نیست؟
اگر هر ماه نام ستونها عوض میشود، فایلها دستی به هم وصل میشوند یا چند واحد تعریف متفاوتی از فروش دارند، مشکل فقط یک نمودار نیست. به تعریف مشترک شاخص، منبع قابلپیگیری و کنترل کیفیت در زمان ورود داده نیاز دارید. خرید ابزار جدید یا طراحی داشبورد زیباتر، بهتنهایی این اختلافها را حل نمیکند.
در داپا، نیاز گزارشگیری و جریان ثبت اطلاعات میتواند در محدودهٔ توسعهٔ نرمافزار اختصاصی بررسی شود؛ اگر هدف، تحلیل خودکار یا پیشبینی باشد، خدمات هوش مصنوعی و اتوماسیون مسیر مرتبطتری است. برای شروع بررسی، یک گزارش فعلی، تعریف شاخصها و توضیح منبع داده را آماده کنید.
پرسشهای متداول
آیا استفاده از اکسل باعث خطای تحلیل میشود؟
اکسل میتواند برای بسیاری از تحلیلها کافی باشد. خطا ممکن است از فرمول، محدودهٔ ناقص، اتصال فایلها یا تفسیر نتیجه بیاید. کنترل نسخه، بررسی چند رکورد و تعریف ثابت شاخصها، مستقل از ابزار لازماند.
آیا دادهٔ بیشتر همیشه نتیجه را دقیقتر میکند؟
خیر. دادهٔ بیشتر ممکن است بعضی نوسانهای تصادفی را کاهش دهد، اما تعریف اشتباه شاخص، دادهٔ تکراری یا نمونهٔ جانبدارانه را خودبهخود اصلاح نمیکند. کیفیت و پوشش داده را کنار تعداد آن بررسی کنید.
برای کشف خطا، اول کدام بخش گزارش را بررسی کنیم؟
از شاخصی شروع کنید که مبنای تصمیم است. تعریف و فرمول آن را روشن کنید، تعداد رکوردها و جمعها را با منبع تطبیق دهید و چند مورد را دستی دنبال کنید. سپس فیلترها، مقادیر خالی و مبنای مقایسه را بررسی کنید.